基于深度学习的语义解析技术演进与多行业部署方案解析
当深度学习从实验室走向产业前线,语义解析技术正经历一场静默而深刻的范式转移。过去五年,基于BERT、GPT等预训练模型的语义理解系统,在意图识别准确率上实现了从78%到92%以上的跨越式提升,但随之而来的部署成本、领域适配和实时性挑战,也让不少企业陷入了「技术先进、落地艰难」的尴尬境地。
语义解析的技术瓶颈与产业落差
传统规则引擎在固定场景下表现稳定,一旦遭遇口语化表达、多轮对话或专业术语,召回率便急剧下滑。而端到端深度学习模型虽然大幅提升了泛化能力,却在推理延迟、显存占用和冷启动数据需求上设置了隐形门槛。以智能客服场景为例,一个包含6亿参数的中文语义模型,单次推理耗时约120毫秒,在并发量超过200QPS时,硬件成本会呈指数级攀升。
更棘手的是行业知识壁垒。医疗、金融、法律等垂直领域的语义解析,不仅需要通用语言理解能力,还要求模型具备对特定术语体系和业务逻辑的深度编码。通用模型直接迁移的准确率往往不足65%,而重新训练则意味着高昂的数据标注成本。
分层架构与领域自适应的落地路径
宁波市特语科技有限公司在服务数十家制造业与政企客户的过程中,逐步沉淀出一套「轻量前置+重量后置」的分层部署方案。该方案将语义解析拆解为三个层级:轻量意图识别层(基于蒸馏后的TinyBERT,参数量压缩至原模型的1/10)、领域知识增强层(通过检索增强生成方式注入企业私有知识库)、以及动态纠错层(结合用户反馈实时微调)。这种架构下,单次推理耗时被压缩到35毫秒以内,同时保持了88%以上的领域准确率。
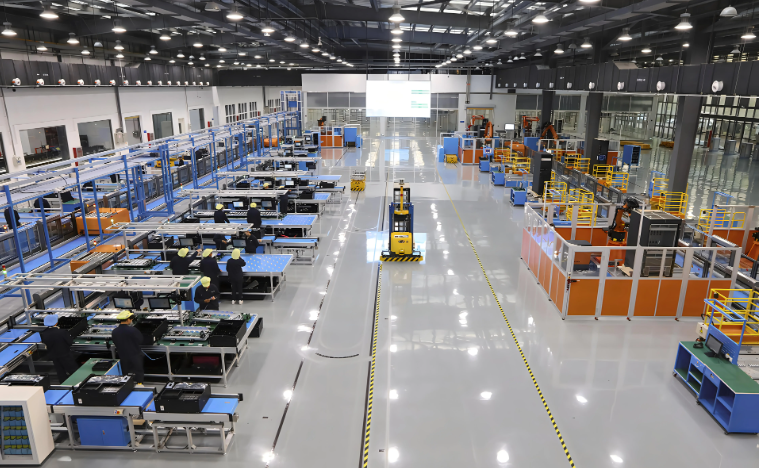
在语音系统集成方面,我们采用端侧降噪与云端语义解析的协同策略。前端麦克风阵列负责信噪比提升,后端则通过流式语义切分技术,将连续语音流按语义完整性动态分段,避免传统VAD(语音活动检测)造成的断句错误。实测数据显示,该方案在嘈杂车间环境下的指令解析成功率,从行业平均的74%提升至89%。
多行业部署中的关键参数调优
不同行业对语义解析的敏感维度截然不同。我们总结了三个典型场景的调优要点:
- 智能语音客服(金融领域):重点调优否定词识别与数字纠错,将「不是要查余额,是查明细」这类否定句式识别错误率降低41%;
- 工业质检语音指令:强化方位词与量词的上下文关联,如「第三排第二个螺丝」的指代消解准确率需达到95%以上;
- 医疗问诊预问询:引入症状-疾病知识图谱约束解码空间,将误报率控制在3%以内。
实践建议是:不要追求单一模型的万能性。我们建议企业采用「小模型快速迭代+大模型离线精修」的双轨机制——线上用轻量模型保证响应速度,每天定时将日志数据回传,用大模型重新标注并蒸馏出更优的小模型版本。这种机制下,系统每周都能获得0.5%-1%的准确率增益,且无需中断业务。
宁波市特语科技有限公司在语言研发过程中发现,语义解析的终极壁垒不在于算法本身,而在于对业务噪音的过滤能力。真实场景中,用户的表述往往包含大量冗余信息、口误和隐含前提。我们通过构建「意图置信度阈值动态调节」机制,在低置信度场景下自动触发澄清追问,而非强行给出错误判断——这比任何模型优化都更能提升用户体验。
回顾近三年的技术演进,从Attention到MoE(混合专家),从单模态到多模态对齐,语义解析正在从「理解文字」走向「理解意图背后的行动逻辑」。对于企业而言,与其追逐每个新模型版本,不如扎实构建一套可持续演进的数据闭环系统。宁波市特语科技有限公司将持续深耕AI语音与语言科技的工程化落地,让先进的语义解析能力真正成为企业数字化底座的水电煤,而非束之高阁的炫技demo。